
- 图像数量
- 6,123 张图像
- 标注类别
- 8 个类别
- 标注格式
- YOLOv8
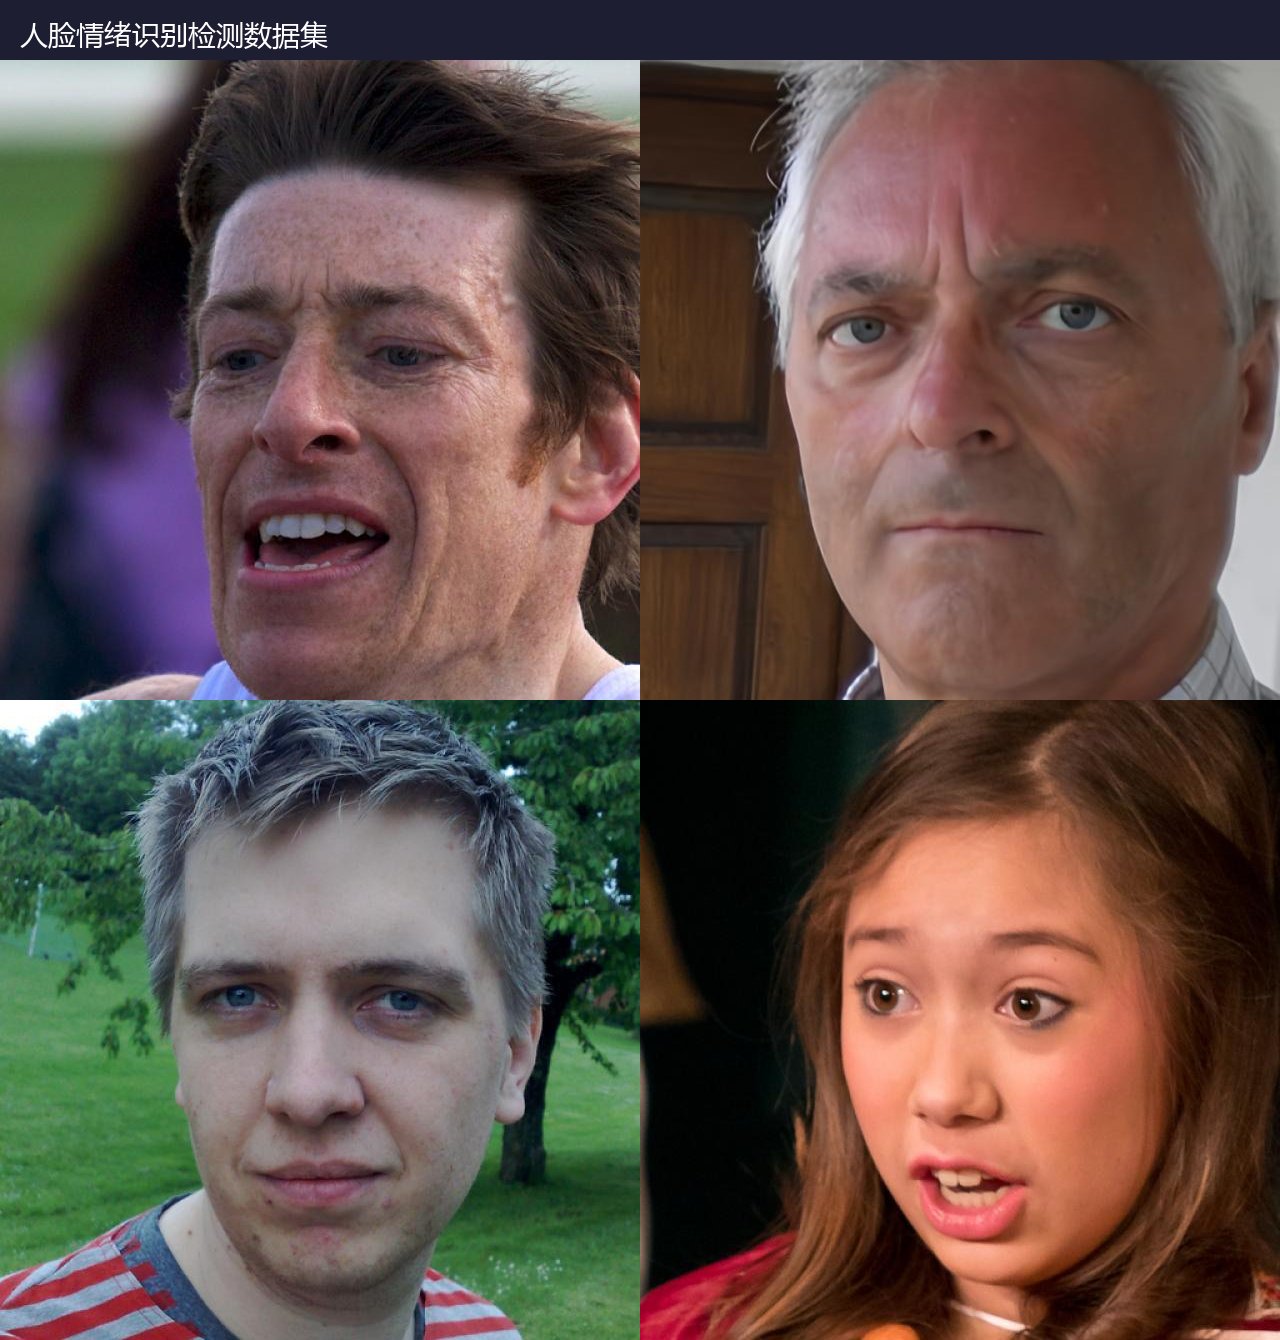
本数据集包含6123张人脸图像,标注8种情绪:Disgust厌恶、Angry愤怒、Excited兴奋、Happy快乐、Worried担忧、Thinking思考、Sad悲伤、Fear恐惧。适用于情感计算、人机交互、客户满意度分析。YOLOv8格式,245MB。
数据集概览
| 图像数量 | 6123张 |
| 标注格式 | YOLOv8 |
| 标注类别 |
|
适用场景
适用于客服中心情绪分析、智能座舱驾驶员情绪监测、人机交互情感反馈、心理健康初筛、市场调研客户情绪统计、互动游戏表情识别等场景。
数据集描述
人脸情绪识别检测数据集面向情感计算与人机交互场景。数据集包含6123张真人面部图像,标注8种基本与复杂情绪:Disgust(厌恶)、Angry(愤怒)、Excited(兴奋)、Happy(快乐)、Worried(担忧)、Thinking(思考)、Sad(悲伤)、Fear(恐惧)。样本覆盖不同性别、年龄、人种和光照条件,能够捕捉从微表情到明显情绪的完整谱。可用于训练实时人脸情绪识别模型,应用于客服情绪分析、互动娱乐、心理健康监测、驾驶员情绪预警等场景。标注为YOLOv8目标检测格式。
相关推荐
常见问题
Q: 这个数据集是什么格式?可以直接用YOLO训练吗?
A: 本数据集为YOLO格式(.txt标注文件+images/labels目录结构),下载解压后可直接用于YOLOv5/YOLOv6/YOLOv7/YOLOv8/YOLOv11等系列模型的训练,无需额外格式转换。
Q: 数据集有多大?包含多少张图片?
A: 具体图片数量和标注类别请参考上方”数据集概览”表格。所有数据集均经过筛选,确保标注质量和场景多样性。
Q: 下载后如何使用?
A: 1. 下载ZIP文件并解压;2. 确认目录结构包含images和labels文件夹;3. 修改data.yaml中的路径指向解压目录;4. 运行训练命令开始训练。建议先在小数据集上验证,再全量训练。
Q: 数据集可以商用吗?
A: 数据集来源于开源社区,具体使用许可请参考原始项目说明。建议用于学习研究和非商业项目,商业使用前请确认原始许可协议。
Q: 训练时推荐什么参数?
A: 推荐初始配置:batch=16(根据显存调整)、imgsz=640、epochs=100、optimizer=AdamW。如果数据集类别不均衡,建议使用–balance-weights或过采样少数类。
训练建议
数据预处理:训练前建议运行数据校验脚本,检查标注文件是否存在空框、越界坐标或格式错误。可使用YOLO自带的`–verify`参数进行验证。
数据增强:开启mosaic、mixup、hsv_h/s/v等增强策略,提升模型泛化能力。对于小目标密集的场景,建议将imgsz提升到1280。
迁移学习:推荐使用预训练权重(yolov8n/s/m/l.pt)进行微调,而非从头训练。冻结前10层可以加快收敛速度。
评估指标:重点关注mAP@0.5、mAP@0.5:0.95、Precision和Recall四个指标。如果Recall偏低,可适当降低置信度阈值。
模型选择:边缘部署选nano/small,服务器推理选medium/large。分类任务建议从YOLOv8-cls开始,实例分割用YOLOv8-seg。
下载说明
登录后通过夸克网盘下载,提取码yolo。
通过夸克网盘分享的文件:人脸情绪识别检测数据集_data2.cn.zip





暂无评论内容